历史版本3 :缓存配置 返回文档
编辑时间:
内容长度:图片数:目录数:
修改原因:
1. 概述编辑
1.1 版本说明
| FineDataLink 版本 |
|---|
| 4.0.4 |
1.2 应用场景
在进行实时同步过程中,需要通过「数据管道」暂存来源数据库中的数据,便于目标数据库写入数据,实现实时数据同步。
1.3 功能说明
FineDataLink 支持使用 Kafka 作为数据同步的中间件,实现:
读写两端分离,以保证在持续增量同步过程中,读写两端不会互相阻塞;
系统的短暂宕机后,已读取的数据可以不必再重复读取;
不能正常写入目标库的脏数据能够暂时存储;
帮助你更好的实现实时数据同步。
1.4 使用限制
当前默认使用 Kafka 开源流处理平台。
2. 前提条件编辑
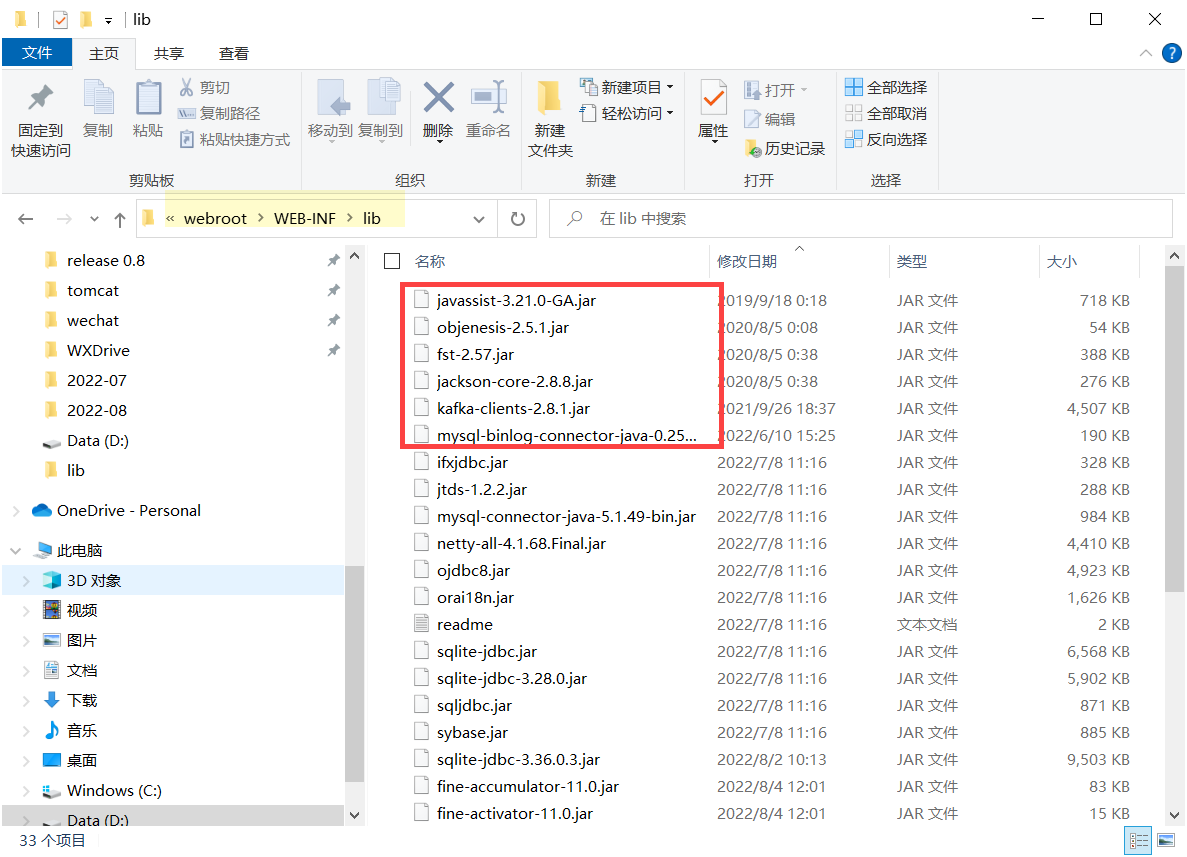
驱动包:kafka.zip
使用前需要将驱动包中驱动解压,并放置在 FineDataLink 工程%FineDataLink%\webapps\webroot\WEB-INF\lib 目录下,如下图所示:
3. 操作步骤编辑
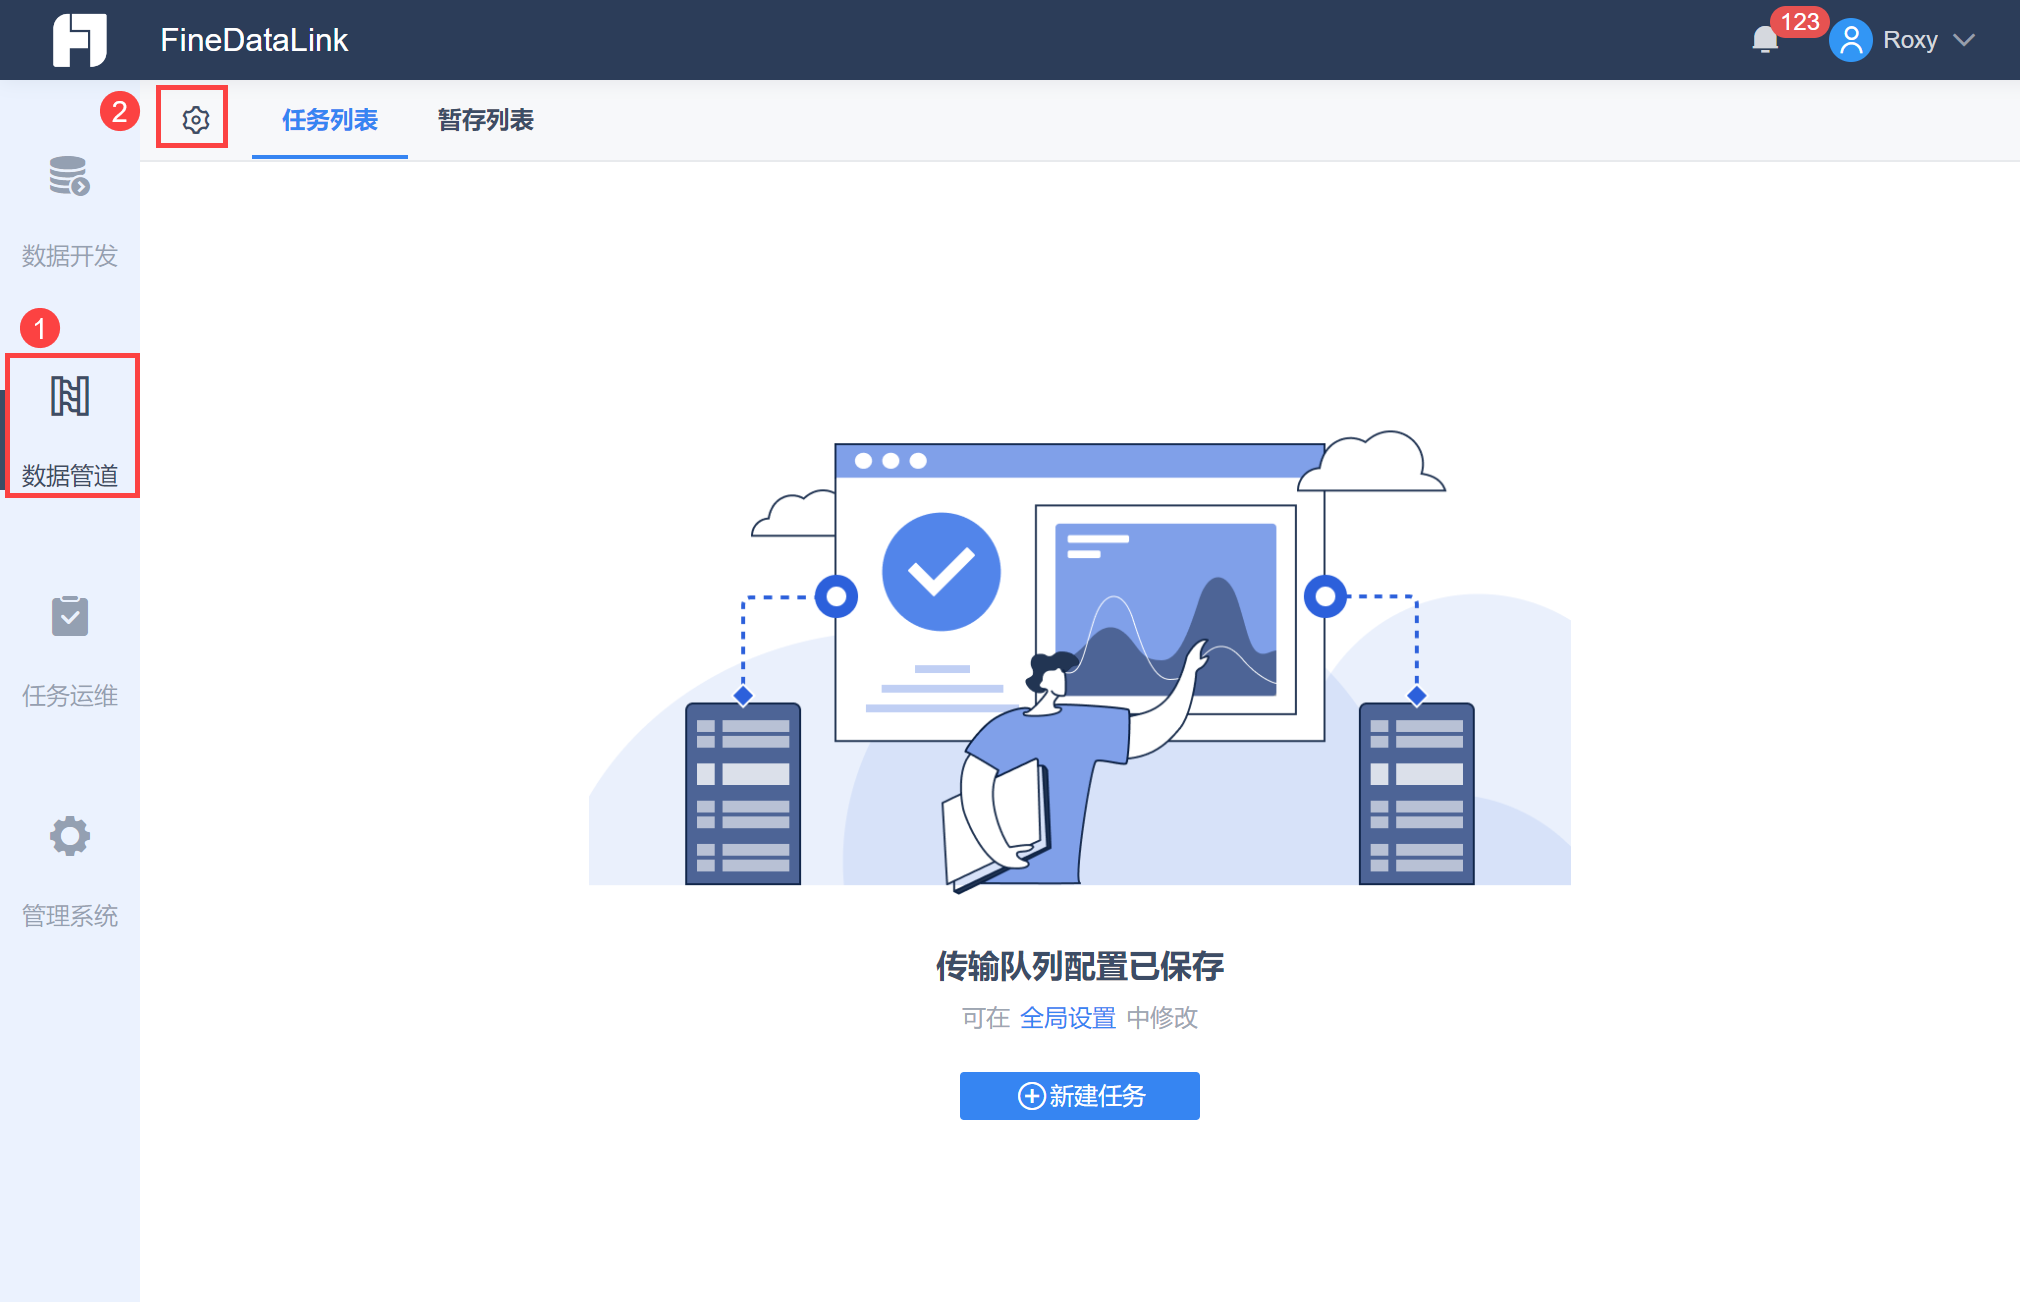
进入 FineDataLink 界面,点击「数据管道」,选择全局设置按钮,如下图所示:
输入 Kafka 地址(填写 IP 和端口),设置数据暂存时间,点击测试连接,如下图所示:
注:Kafka 数据暂存时间不可超过 90,超出后将采用“先进先出”的原则清理。
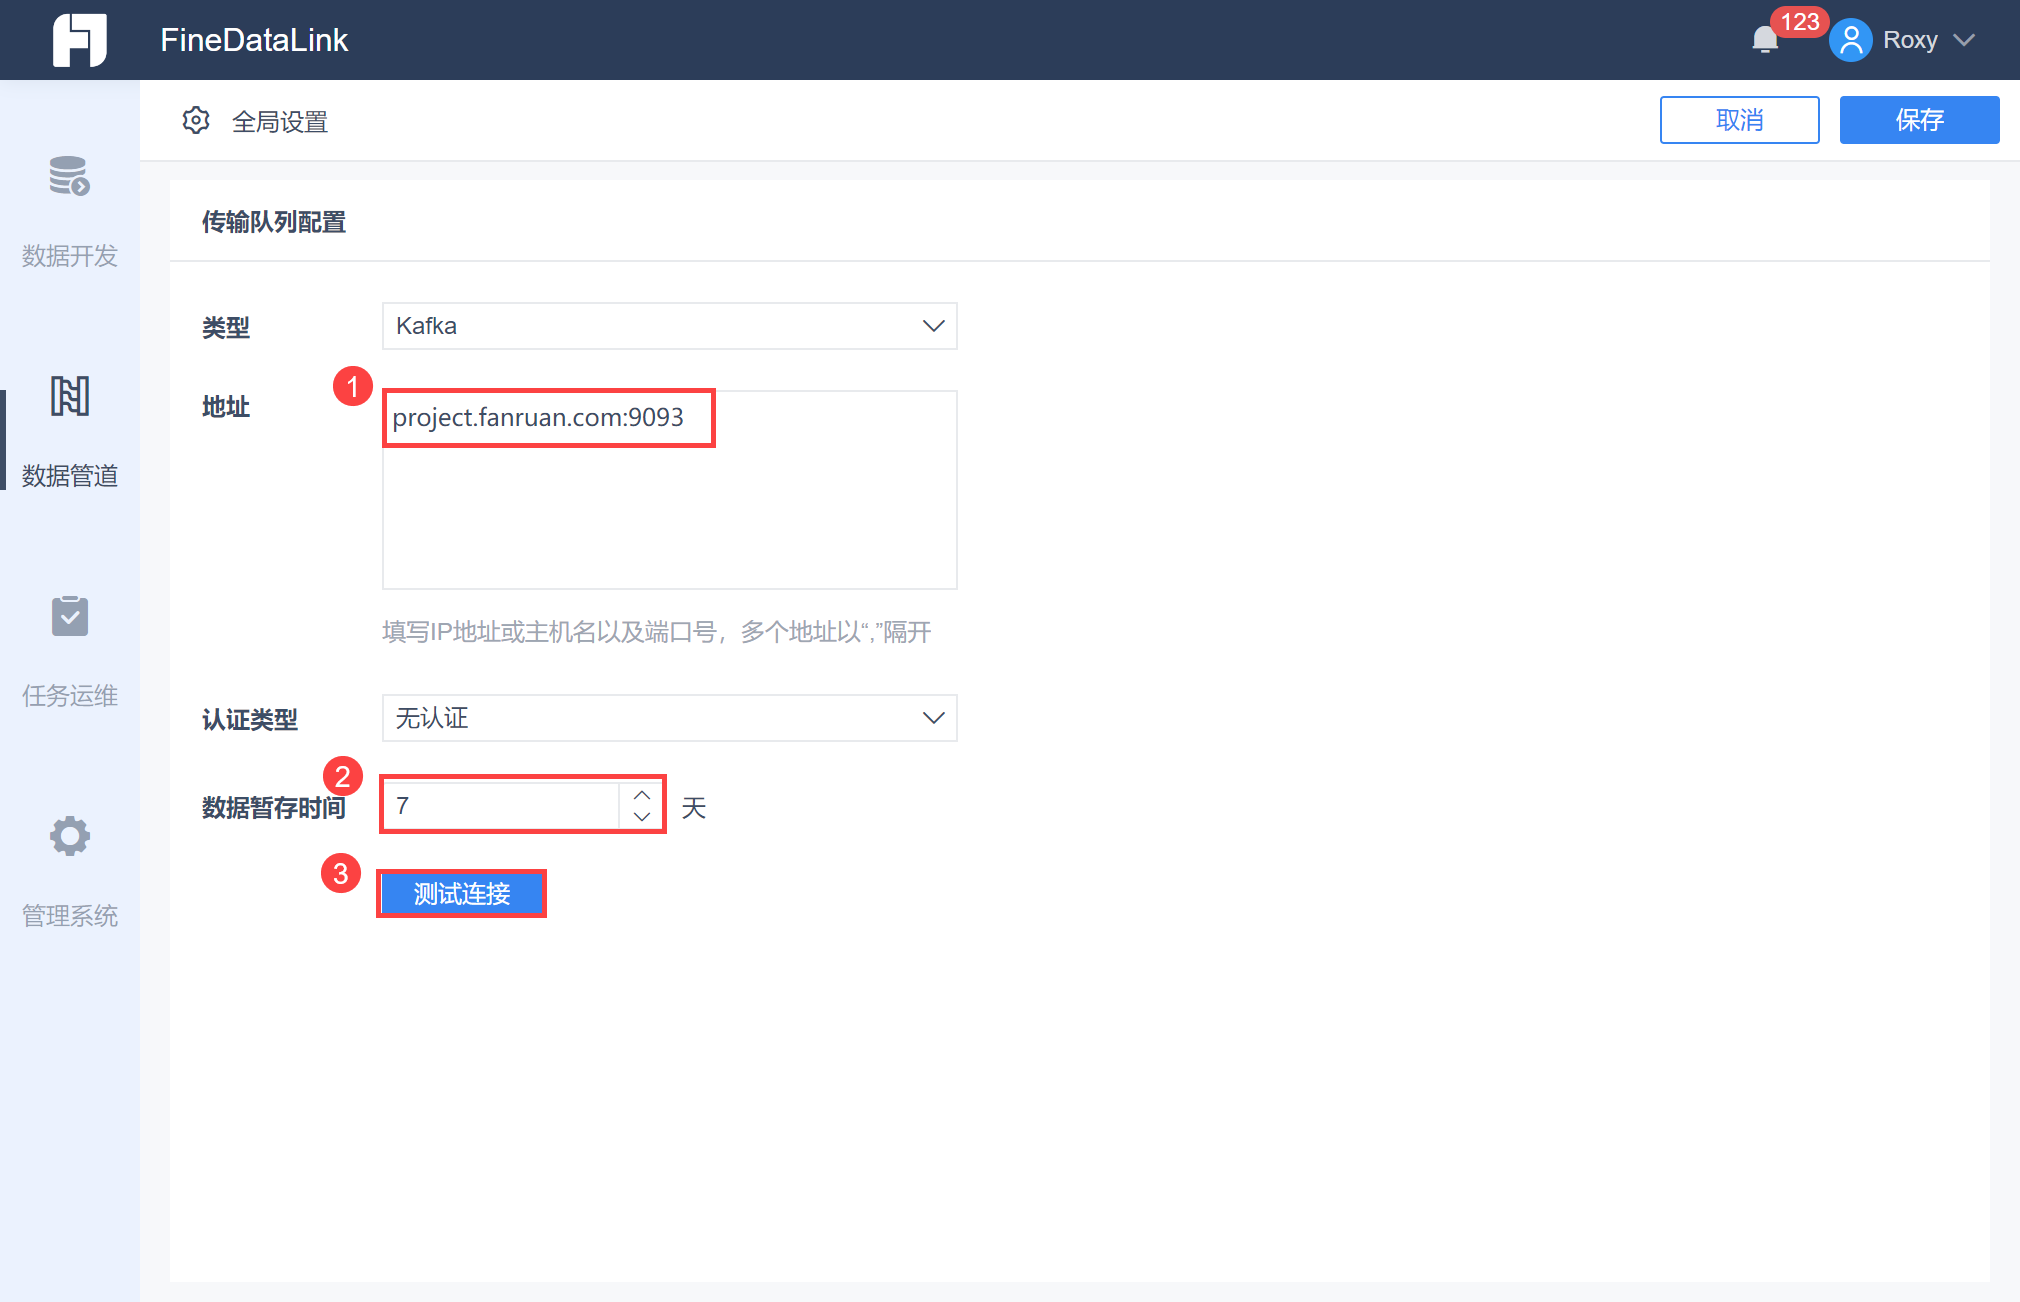
注:支持 Kafka 单机或集群。
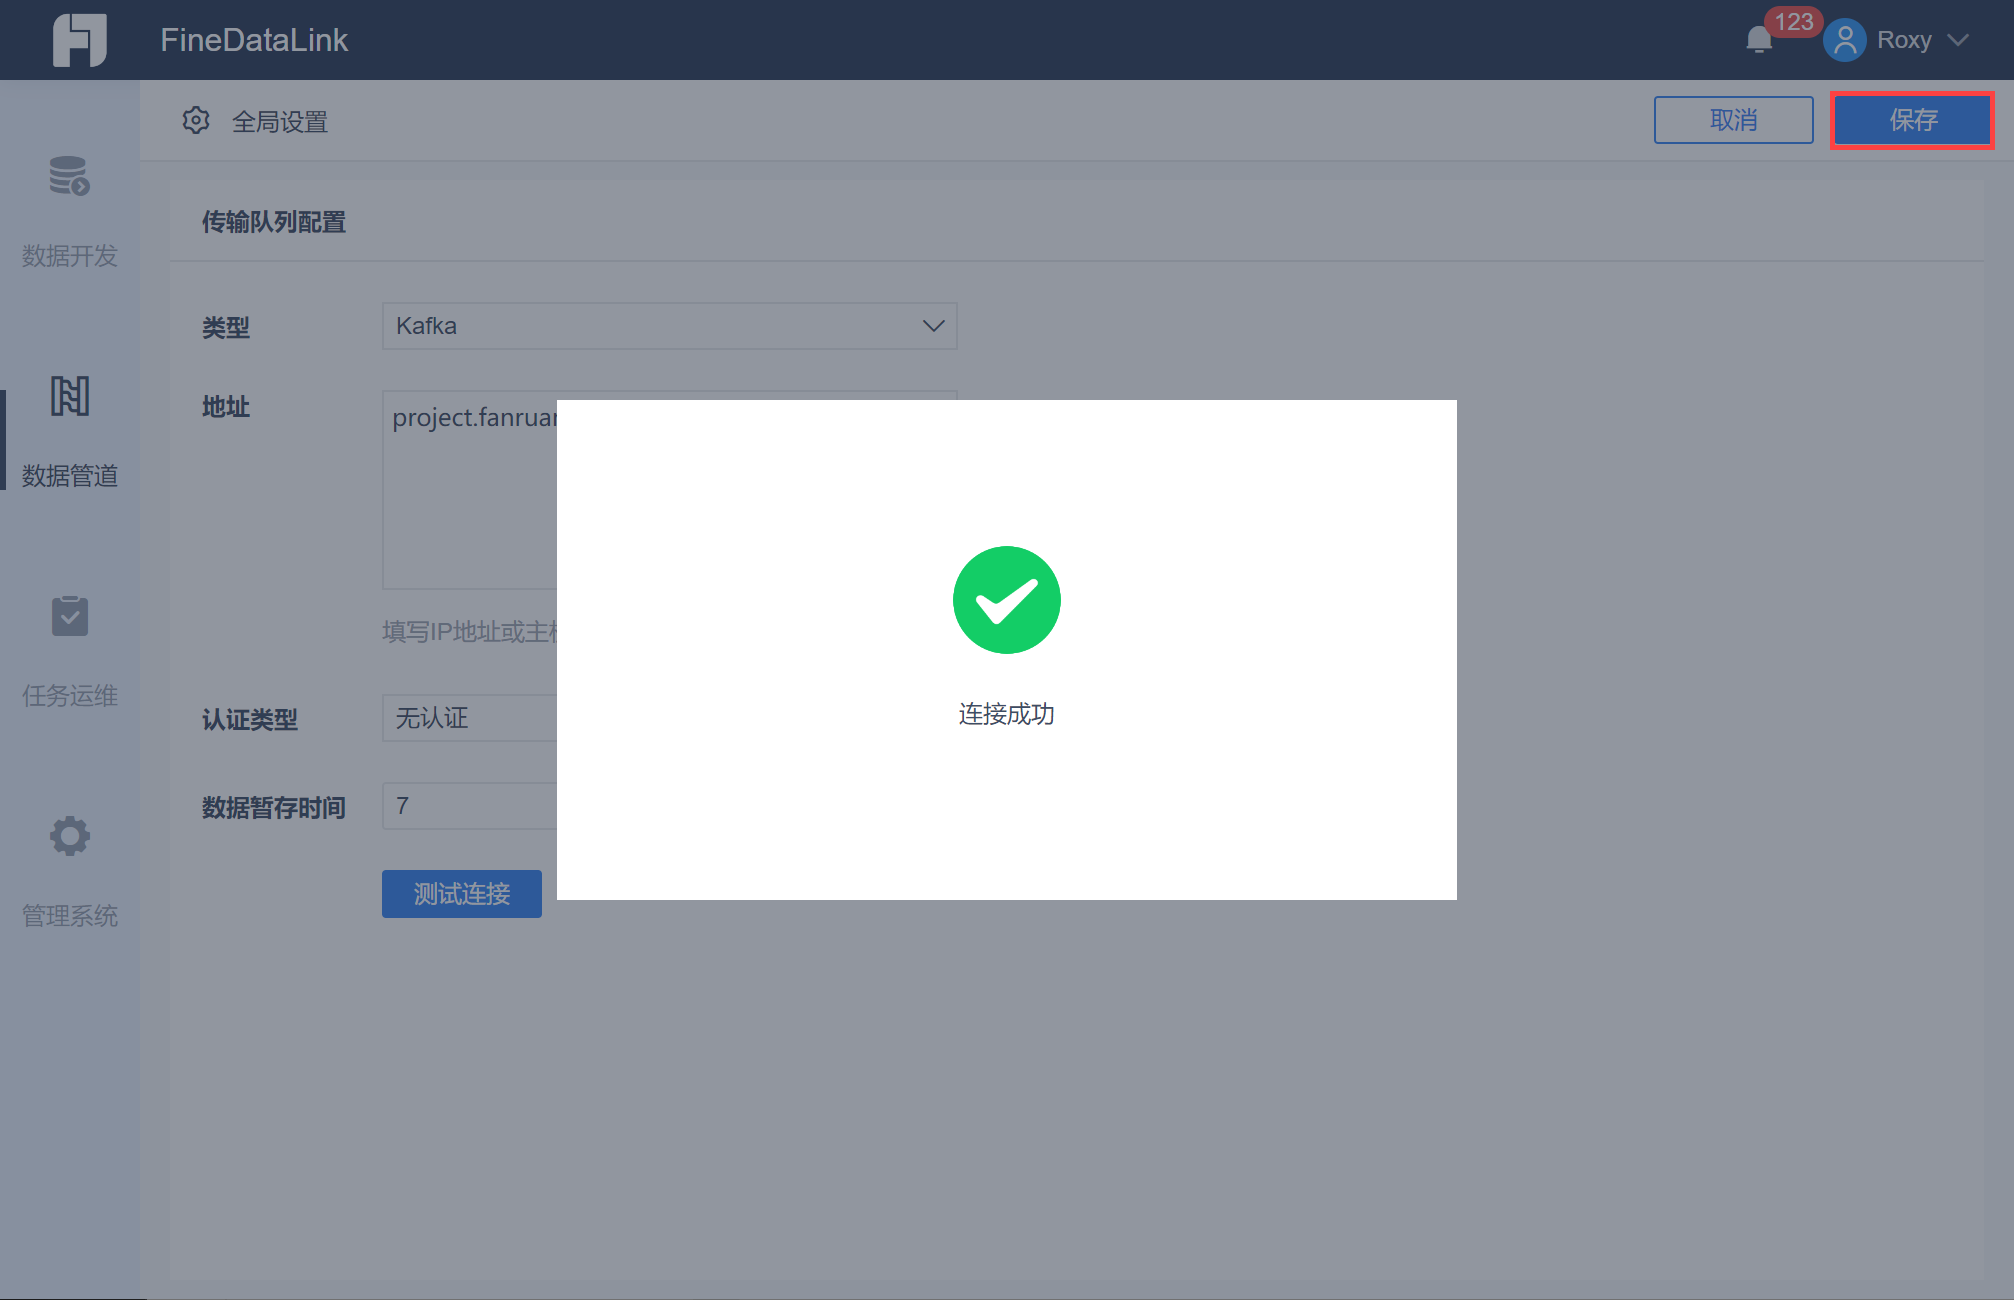
提示连接成功,即可点击保存,配置成功,如下图所示:
4. 注意事项编辑
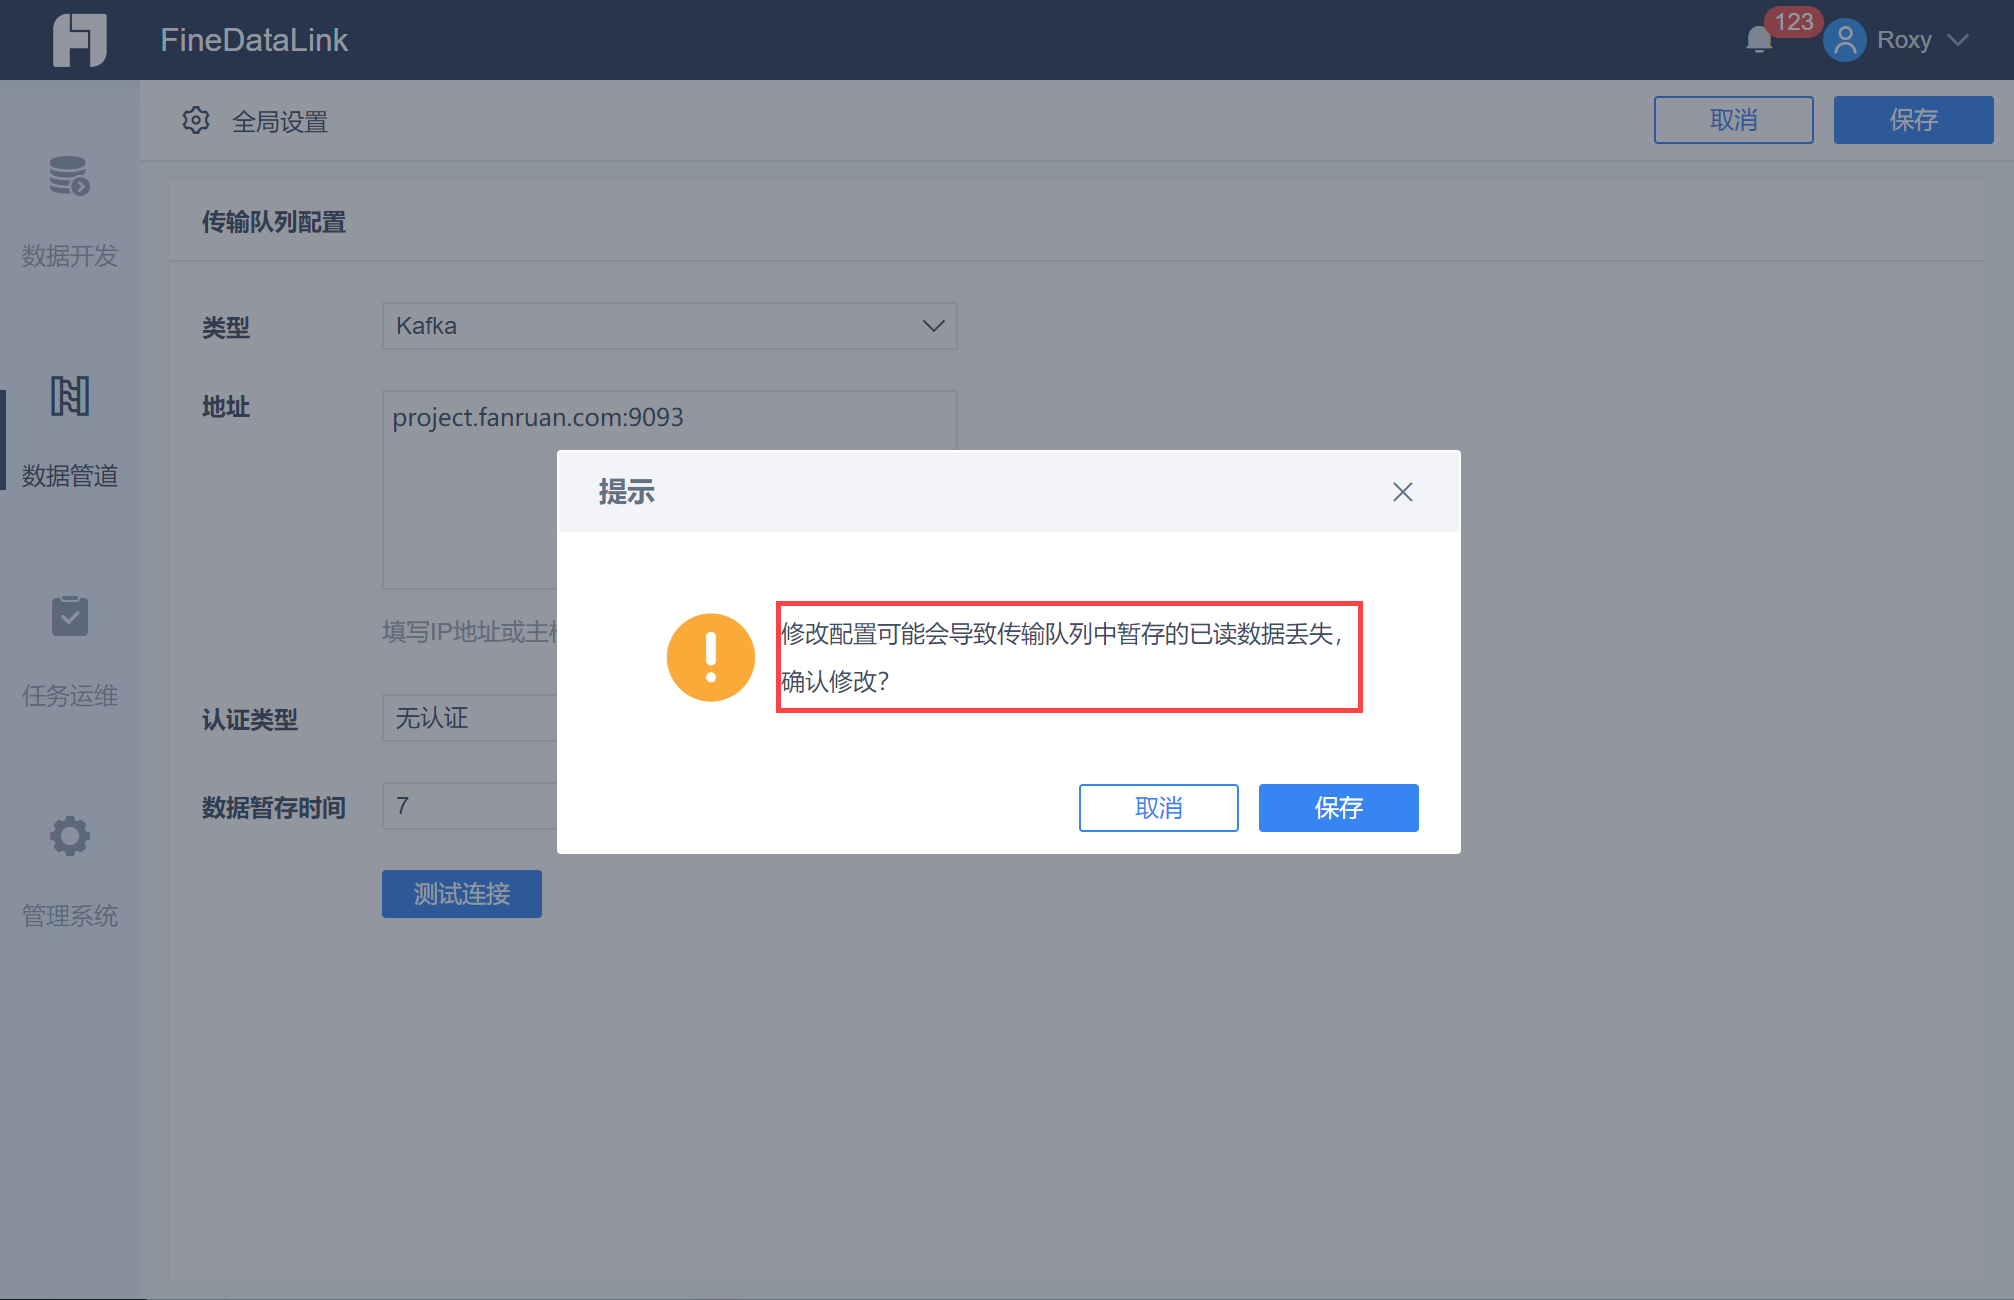
若你修改了 Kafka 配置,可能会导致之前设置的数据管道任务中暂存在 Kafka 中的已读取数据丢失,请谨慎修改,如下图所示: